公开材料 · 产品实跑 · 保留失败与核对
从 Zotero 两篇论文,
到可以点开的回答依据。
DPR × FiD:一次导入、一次对比,以及一次引用格式修复后的阅读问答。
先说结果
两篇论文及 PDF 完整导入,结构化版本在索引连接修复后发布;对比分析与单篇阅读问答完成。复测中的引用在桌面、手机均可展开。流程走通,不等于模型每句话都正确:下文保留需要修正的地方。
01 / 不搬整个库,先选两篇
选中 DPR、FiD 两个父条目,右键“发送到 Literature Workspace”,再在网页核对请求和目的库并确认。菜单保留旧名称,对应 VibeResearch。
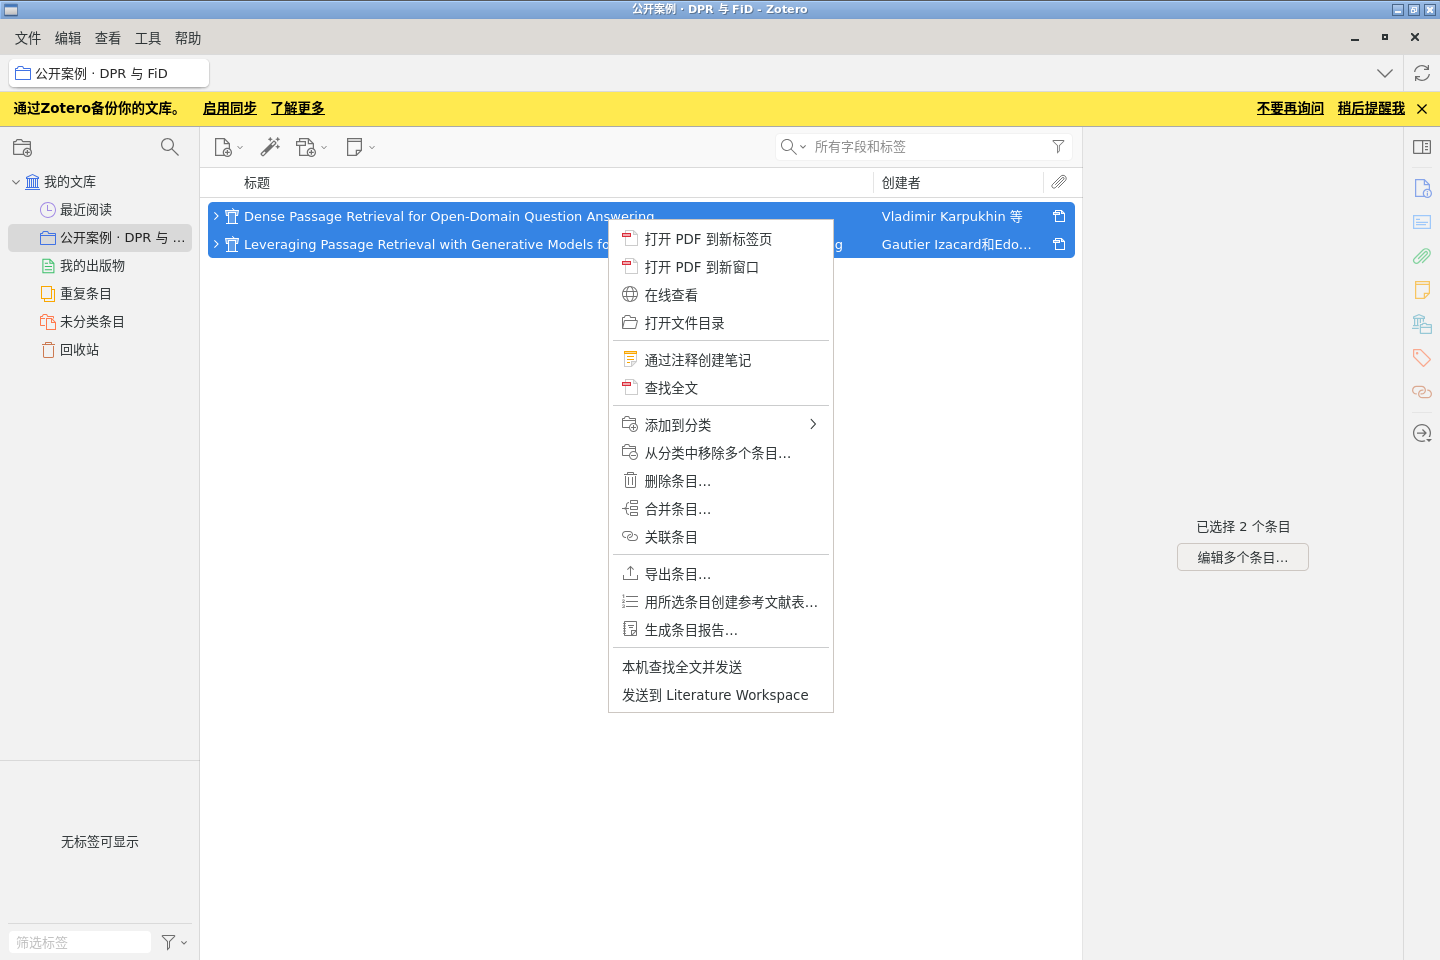
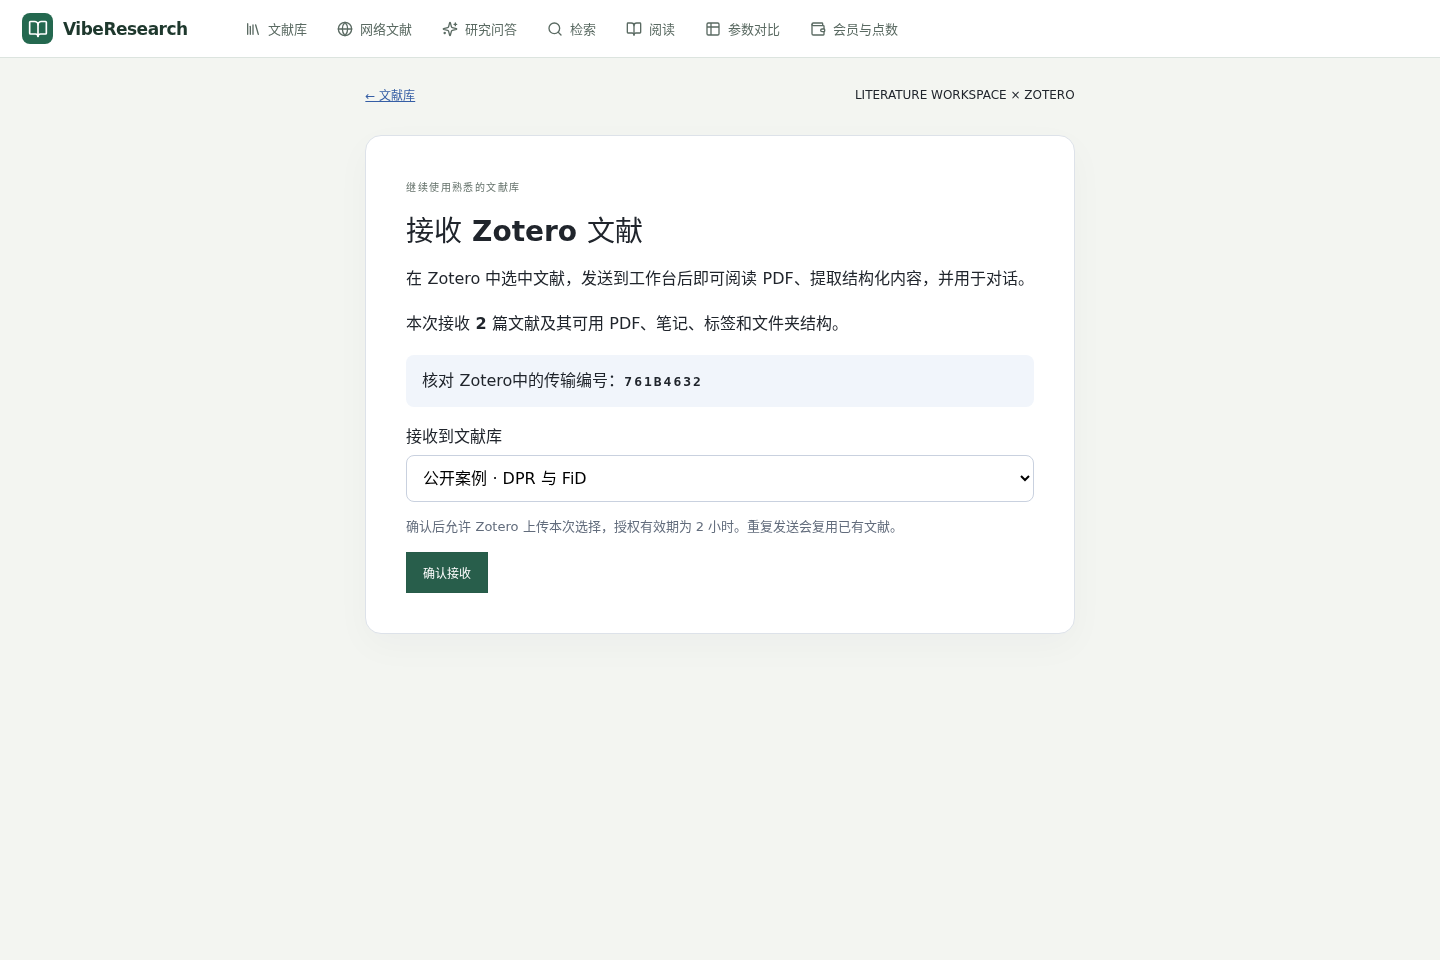
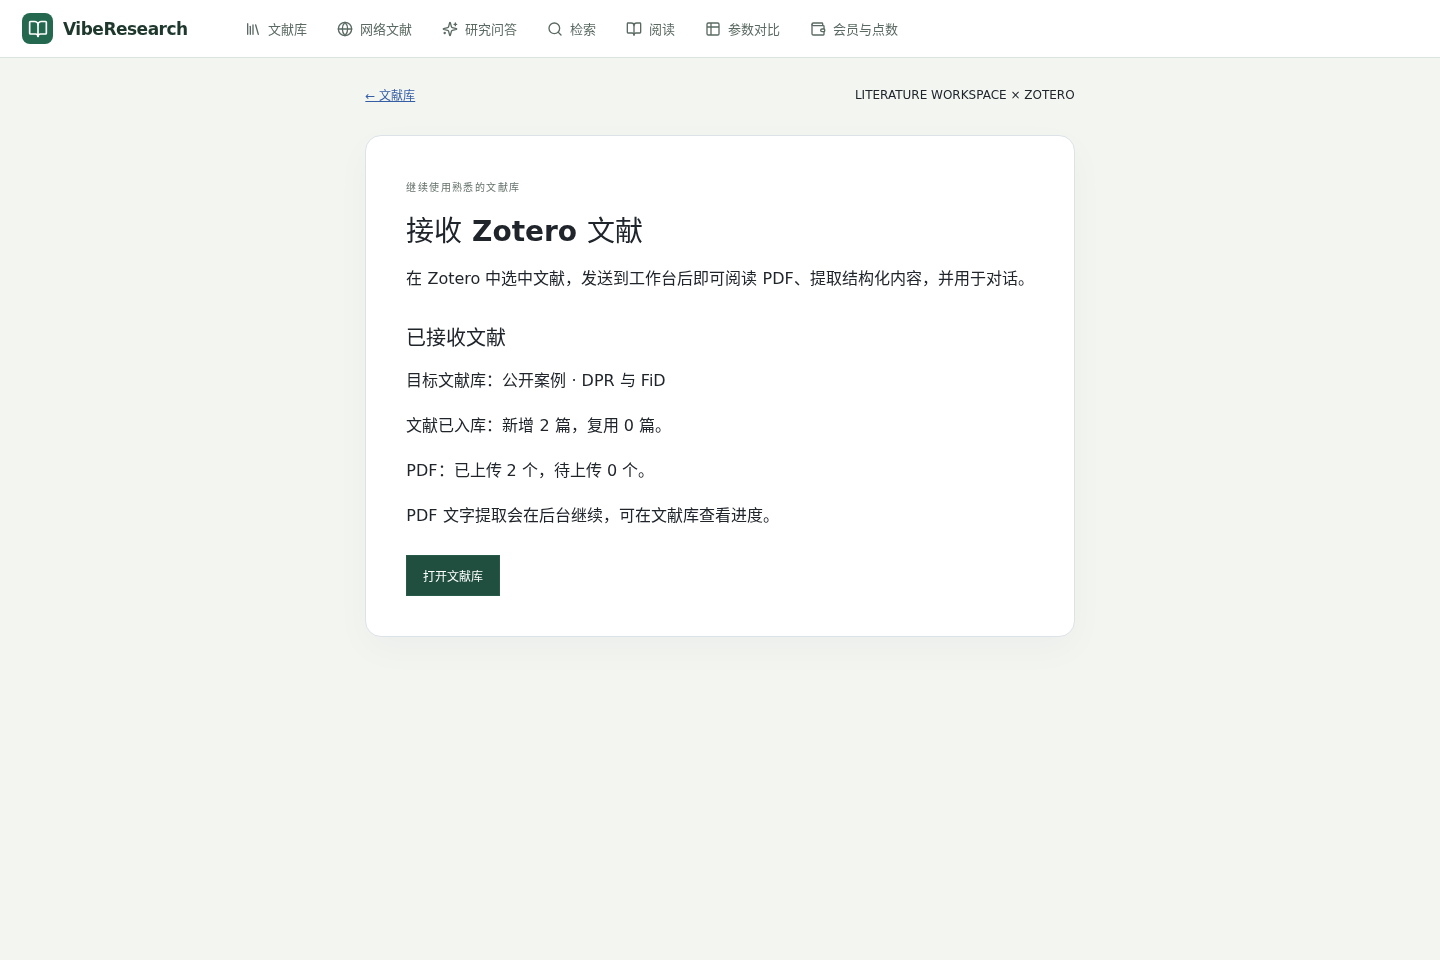
重新下载网站保存的 PDF 后,标题、DOI 和 SHA256 均与原材料一致。环境为 Linux、Zotero 10.0.2、插件 0.1.0;独立 profile 的初始条目由 Zotero 原生 API 准备,实际发送使用真实菜单。这是单向发送,不是双向同步。
查看 Zotero 接入步骤与限制 →02 / 78.4 和 51.4,能直接比吗?
结构化就绪后,选定两篇创建对比并点击“生成分析”。这两个数字分别对应段落检索和答案评测,不能仅凭大小判断哪个方法更好。
查看这次实际提交的完整问题
仅根据所选两篇论文的轻量结构化条目,比较研究目标、检索器或生成器所处环节、评测指标及其适用范围。每个事实给出具体条目引用。重点检查:DPR 的 top-k 段落检索准确率,能否与 FiD 的答案 exact match 直接比较?资料没有提供的数字写“未找到证据”;不要推断一种方法在所有场景全面更好。
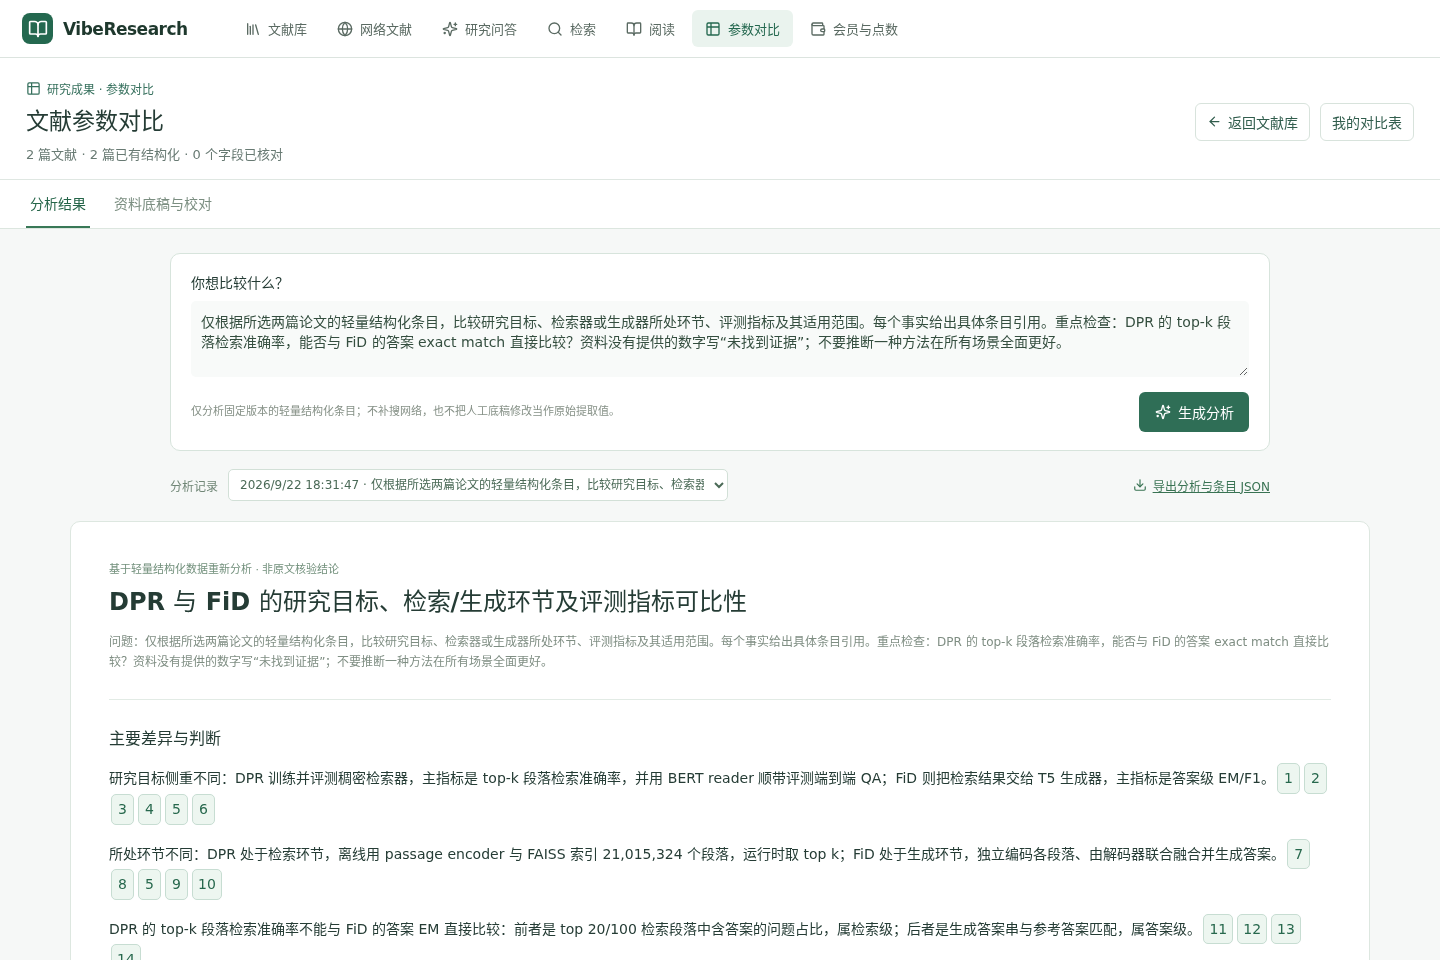
模型原始判断节选
DPR 的 top-k 段落检索准确率不能与 FiD 的答案 EM 直接比较:前者是 top 20/100 检索段落中含答案的问题占比,属检索级;后者是生成答案串与参考答案匹配,属答案级。
该句原始引用:P1.E44、P1.E76、P2.E50、P2.E14。下面可展开保存的条目。
P1.E44展开本次保存的条目
Dense Passage Retrieval for Open-Domain Question Answering · Device Performance Characterization · Data Reduction
Top-k accuracy: fraction of questions for which top-k retrieved passages contain an answer span; exact match: normalized answer string matches reference; run-time measured on specified server; latency approximately 20 ms for 100 passages on single 32GB GPU轻量结构化整理,不是论文逐字原文;这是已保存的案例证据,不会发起实时问答。P2.E50展开本次保存的条目
Leveraging Passage Retrieval with Generative Models for Open Domain Question Answering · Device Performance Characterization · Data Reduction
Exact Match: generated answer is correct if it matches any acceptable answer after normalization, which consists of lowercasing and removing articles, punctuation, and duplicated whitespace. F1 is also used for SQuAD Open. TriviaQA uppercase answers normalized by converting all letters to lowercase except the first letter of each word using the Python `title` string method. Best checkpoint selected on validation Exact Match. Evidence: Section 4 Experiments (Evaluation, Technical details).轻量结构化整理,不是论文逐字原文;这是已保存的案例证据,不会发起实时问答。| 数字 / 判断 | 原文位置 | 核对结果 |
|---|---|---|
| 78.4 | DPR Table 2,PDF 第 5 页 | Single DPR、NQ、top-20 检索准确率 |
| 51.4 | FiD Table 1,PDF 第 3 页 | FiD large、NQ、答案 EM |
| DPR 也有答案 EM | DPR Table 4,PDF 第 7 页 | NQ 为 41.5;不能说两篇所有结果都不可比较 |
同为 EM 可以记录论文报告的差异,但不能把整条问答管线的差异归因于单一部件;还要核对模型、训练、数据与阅读段落数。查看对比流程 →
03 / 点开引用,再看它支持什么
在 FiD 阅读器选择“结构化”,针对当前文献提问。此次任务保存的来源确为 STRUCTURED,未调用网络或其他文献工具。
查看阅读问题与未经改写的复测回答
实际问题
只依据当前论文的轻量结构化内容,用不超过250字说明方法怎样使用多个检索段落,以及实验结果的适用边界。每个事实附具体条目引用。如果现有条目不足以回答,就明确说明。能否据此断言所有任务中检索段落越多越好?请区分论文报告和你的推断。
模型原始回答
方法:BM25/DPR检索段落[Rb7f8295ef5d44c93.E12];FiD各段独立编码,解码器对所有段落表示拼接注意力后生成答案[Rb7f8295ef5d44c93.E12]。独立编码计算随段数线性增长,联合解码融合多段证据[Rb7f8295ef5d44c93.E76][Rb7f8295ef5d44c93.E21]。 适用边界:结果限于NQ、TriviaQA、SQuAD Open;默认100段,NQ/TriviaQA用DPR、SQuAD用BM25,截断250词片,贪心解码[Rb7f8295ef5d44c93.E31][Rb7f8295ef5d44c93.E49]。论文报告10→100段使TriviaQA+6%、NQ+3.5%,多数抽取模型约10–20段达峰[Rb7f8295ef5d44c93.E32][Rb7f8295ef5d44c93.E56];当前资料未提供SQuAD缩放或>100段趋势[Rb7f8295ef5d44c93.E31][Rb7f8295ef5d44c93.E32]。 不能断言所有任务中越多越好。论文报告仅NQ/TriviaQA增益[Rb7f8295ef5d44c93.E2][Rb7f8295ef5d44c93.E77];现有条目不足以推广到所有任务或无限增加,此为我的推断[Rb7f8295ef5d44c93.E31]。
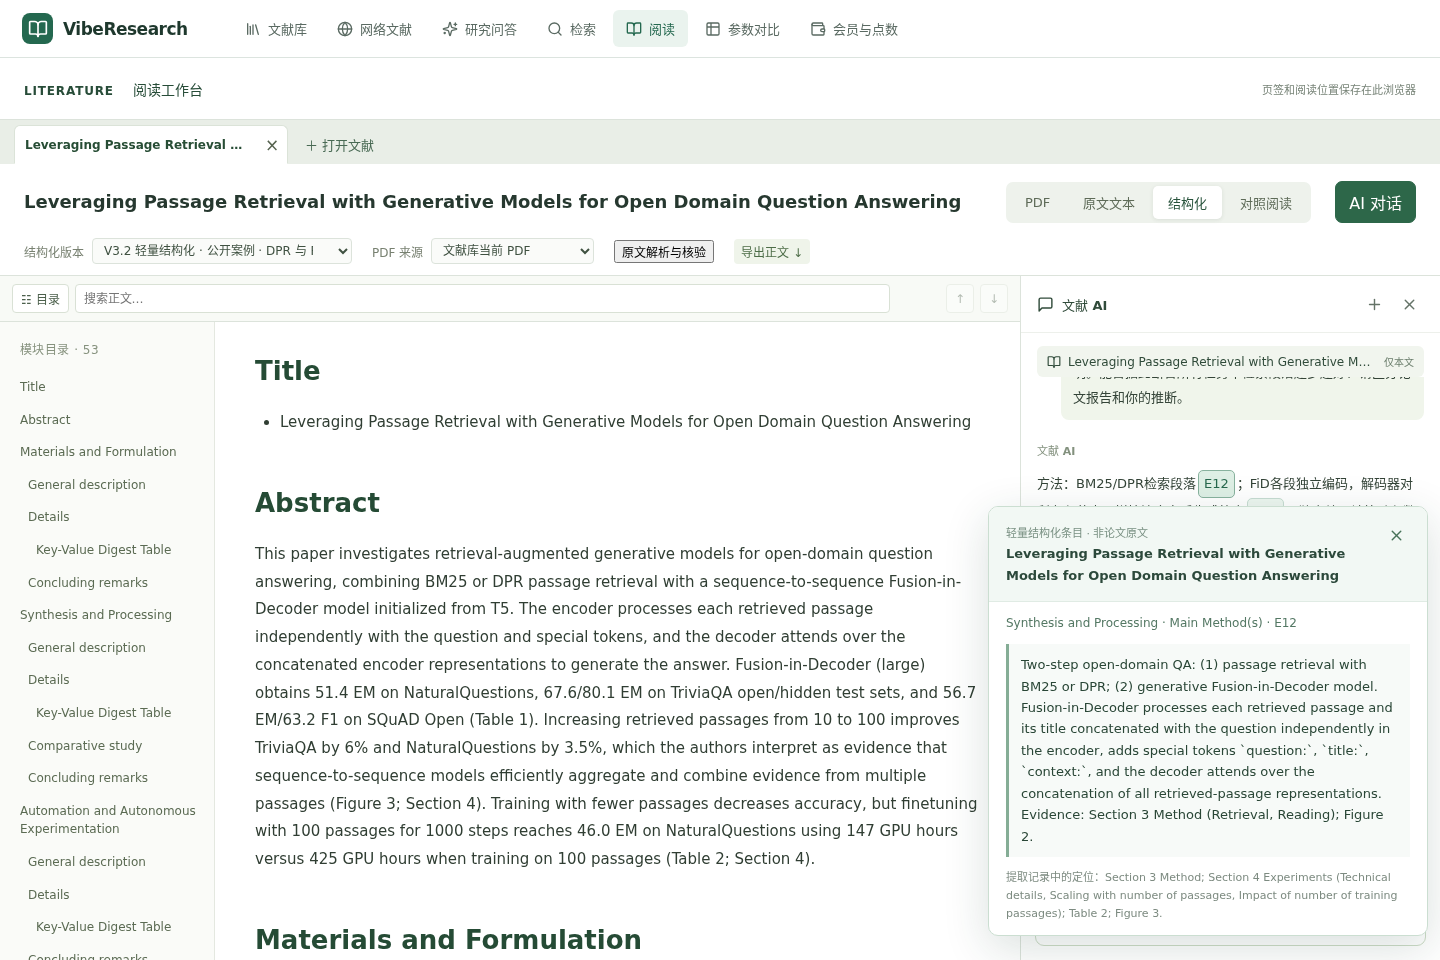
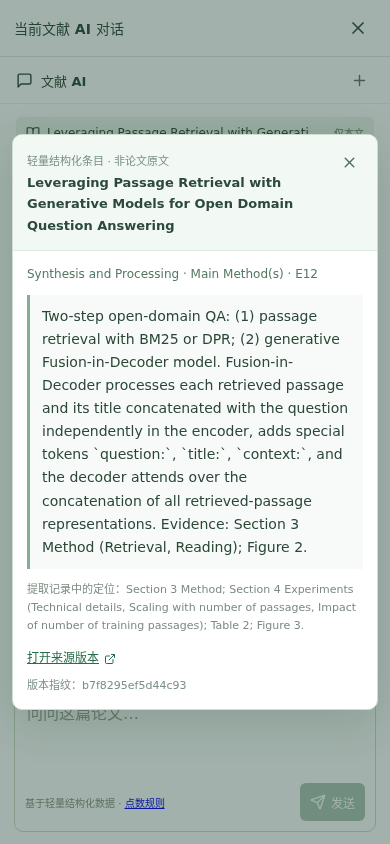
同一个条目,两种打开方式
桌面悬停和手机点击的弹窗内容,与任务保存的条目逐字一致。9 个引用条目均能在输入快照中定位;这项检查验证来源关联,不自动验证结论。
FiD Figure 2 与 §3 Reading 支持“分别编码段落,在解码端结合表示”。Figure 3 展示特定数据集与段落数量下的观察,不能推广为所有任务中检索越多越好。
怎样判断引用真正支持回答 →Rb7f8295ef5d44c93.E12展开本次保存的条目
Leveraging Passage Retrieval with Generative Models for Open Domain Question Answering · Synthesis and Processing · Main Method(s)
Two-step open-domain QA: (1) passage retrieval with BM25 or DPR; (2) generative Fusion-in-Decoder model. Fusion-in-Decoder processes each retrieved passage and its title concatenated with the question independently in the encoder, adds special tokens `question:`, `title:`, `context:`, and the decoder attends over the concatenation of all retrieved-passage representations. Evidence: Section 3 Method (Retrieval, Reading); Figure 2.轻量结构化整理,不是论文逐字原文;这是已保存的案例证据,不会发起实时问答。这次实跑,也留下了这些问题
- 首次索引连接失败,两篇各重试一次后发布,复用了原结构化输出。失败记录没有删除。
- 阅读问答首次把引用缩写成“R...”,无法展开;补强完整编号提示后,用同一个问题进行了第 2 次任务。不是只展示一次命中的结果。
- 对比原始判断第 4 条混用了 top-100 候选与读者段落数。DPR §6.2 写明 NQ 最优 k=50,原句不能当作已核对事实。
- “NQ 版本可能不同”只能保留为待核实;结构化未写清,不等于已证实版本不同。FiD 在 NQ/TriviaQA 也使用 DPR,不能说检索器一定不同。
- 阅读复测回答去掉引用及空白后仍有 281 个字符,未严格达到 250 字符限制;“拼接注意力”更准确应说对拼接后的表示做注意力。原始回答保留。
- 当前 materials_v32 模板偏材料研究,NLP 论文出现不适用栏目。此次不是跨学科完整提取评测,也不证明后续引用永远正确。
这份案例证明的是可回查的工作流程,不是“零幻觉”或全面准确率承诺。
材料、署名与原始记录
仅使用专用内部账号和两篇 ACL 公开出版论文,没有使用客户私人文献。
- Karpukhin 等(2020):Dense Passage Retrieval for Open-Domain Question Answering。
- Izacard、Grave(2021):Leveraging Passage Retrieval with Generative Models for Open Domain Question Answering。
依照 ACL 版权说明与 CC BY 4.0 使用。结构化条目为模型整理,中文核对由维护者撰写;不代表论文作者或 Zotero 官方背书。
下载本次输出、引用条目、PDF / 结构化哈希及人工核对记录(JSON)
账号、会话和内部地址不在公开包内。浏览案例不执行模型、不消耗账户点数。完整原始分析没有被全部认证为正确。
把流程用到自己的两篇论文
先选少量有权处理的材料,确认处理就绪,再提一个具体问题;最后点开证据、回到原文。
可以先浏览界面,管理文献或发送问题时再登录。